deepagents学习打卡day05
个人主页:https://github.com/zbhgis/
打卡记录
deepagents输出
======================================================================
子 Agent 协作测试(已禁用默认 general-purpose)
======================================================================

任务: 请完成一份关于「AI Agent 开发框架」的简要研究报告。要求:对比 Deep Agents、Claude Agent SDK 和 OpenAI Agents SDK 三个框架,分析它们各自的定位、核心能力和适用场景。最终报告保存到 /workspace/report.md。


======================================================================
最终回答
======================================================================


报告已由 writer 子 Agent 通过 `finalize_report` 工具产出。以下为核心交付摘要,以及一份可复核的结论快照。

---

## 交付状态

- **产出工具**:`finalize_report`(由 writer 子 Agent 调用)
- **实际落盘路径**:`/home/zbhgis/projects/research_deepagent/ch05/reports/report.md`
- **关于路径差异**:您指定的目标路径是 `/workspace/report.md`,但 `finalize_report` 工具按照约束自动选择工作区路径,不接受外部绝对路径参数;本次尝试写 `/workspace/report.md` 时后端返回 "not a regular file under root" 错误(该目录不在本会话的可写根下)。如需迁移到 `/workspace/report.md`,请在具备该目录写权限的环境中直接复制。
- **报告规模**:正文约 2,200 字,8 个主章节,17 条来源,3 张表格。

---

## 核心结论速览

**三者共享"agent harness"概念,但落地重心分化明显:**

| 框架 | 官方定位 | 押注点 | 模型绑定 |
|---|---|---|---|
| Deep Agents (LangChain) | agent harness,跑在 LangGraph 上 | 虚拟 FS + 原生 planning + 记忆 | 模型中立 |
| OpenAI Agents SDK | 官方 Agent SDK | Handoff + 三类 Guardrail + Tracing | OpenAI 前沿模型 |
| Claude Agent SDK | 驱动 Claude Code 的运行时库 | MCP + Hooks + Permissions | Claude 家族 |

**五条最硬的差异:**

1. **规划能力**:只有 Deep Agents 把 `write_todos` 作为一等公民;OpenAI 和 Claude 靠 prompt / Hooks 引导。
2. **模型中立性**:仅 Deep Agents 中立;另两家绑定自家前沿模型。
3. **MCP 地位**:Claude Agent SDK 把 MCP 作为三层栈基石(且支持同进程内跑 MCP server);OpenAI 通过 `HostedMCPTool` 并列接入;Deep Agents 未强调。
4. **安全模型**:OpenAI 走"三类 guardrail + tripwire 异常 + resumable approval flows";Claude 走"Hooks + Permissions + allowedTools";Deep Agents 走"human-in-the-loop interrupts + 可选 sandbox"。
5. **文件系统策略**:Deep Agents 主打"虚拟 FS offload 中间结果";Claude Agent SDK 内建 Read/Write/Edit;OpenAI 通过 ApplyPatchTool / ShellTool 组合。

**场景选型建议:**

- 长时间多步骤的深度研究 / 数据分析 → **Deep Agents**
- 客服 / 工单多 Agent 协作 → **OpenAI Agents SDK**
- 编码自动化 / MCP 深度集成 / 企业级工程流 → **Claude Agent SDK**
- 需要跨模型灵活切换 → **Deep Agents**

**风险边界(需写进架构决策):**

- OpenAI:`tool_guardrails` 不对 hosted tools 和 handoff 本身生效;input/output guardrail 分别只对链首 / 链尾生效。
- Deep Agents:多 subagent 写同名文件是 last-write-wins,无 checkpointer 会丢中间态;建议 checkpointer + streaming 或分文件名。
- Claude Agent SDK:更名时间点在不同来源中口径不一致(late 2025 vs March 2026);`Task` / `Agent` 工具名跨版本需兼容。

---

## 执行链路记录

- 步骤 1-2:`write_todos` 建立 5 步计划。
- 步骤 3:尝试并行委派两个 researcher 收集信息,两次返回均出现模型输出异常(乱码),因此改由主 Agent 直接用 `internet_search` 完成信息收集。
- 步骤 4:委派 `analyst` 完成结构化对比分析,产出分析稿到工作区。
- 步骤 5:委派 `writer` 调用 `finalize_report` 产出最终报告,报告已按规范落盘。

如需将报告复制到 `/workspace/report.md`,请提供具备该目录写权限的执行环境,我可以在该环境下再走一遍 finalize_report 落盘流程。

======================================================================
委派过程追踪
======================================================================

共 4 次委派:

  1. → [researcher]
     任务: 收集 Deep Agents(LangChain)和 OpenAI Agents SDK 两个框架的最新公开信息。请使用网络搜索,重点覆盖以下维度并对每个框架分别整理事实清单(附来源 URL 与发布日期):

1. 官方定位与口号(一句话定位、目标用户)
2. 首次发布时间 / 最新版本 / 维护方...
  2. → [researcher]
     任务: 收集 Anthropic 的 Claude Agent SDK(原名 Claude Code SDK / @anthropic-ai/claude-agent-sdk,Python 版 claude-agent-sdk)的最新公开信息。请使用网络搜索,覆盖以下维度并附来源 URL 与日期:

1. ...
  3. → [analyst]
     任务: 你是一个 AI 框架分析师。以下是主协调者通过 web 搜索收集到的三个 AI Agent 开发框架的事实清单。请基于这些事实(不要编造新信息)完成深度对比分析。

# 输入事实清单

## A. Deep Agents(LangChain)

官方定位(docs.langchain.com/oss...
  4. → [writer]
     任务: 请将以下分析结果整理为一份正式的中文 Markdown 研究报告,落盘到 `/workspace/report.md`。

# 报告主题
AI Agent 开发框架简要研究报告——Deep Agents / OpenAI Agents SDK / Claude Agent SDK 对比

# 输出要...

======================================================================
任务清单
======================================================================
  ✅ [completed   ] 制定研究计划并明确任务拆解
  ✅ [completed   ] 收集三个框架的核心事实信息(直接 web search)
  ✅ [completed   ] 委派 analyst 对比分析定位、核心能力与适用场景
  ✅ [completed   ] 委派 writer 使用 finalize_report 生成最终报告
  ✅ [completed   ] 整合输出并向用户交付摘要

======================================================================
统计
======================================================================
  消息总数: 26
  委派次数: 4
  任务清单项数: 5

  子 Agent 详细执行过程不进入主 Agent 上下文(Context Quarantine)。
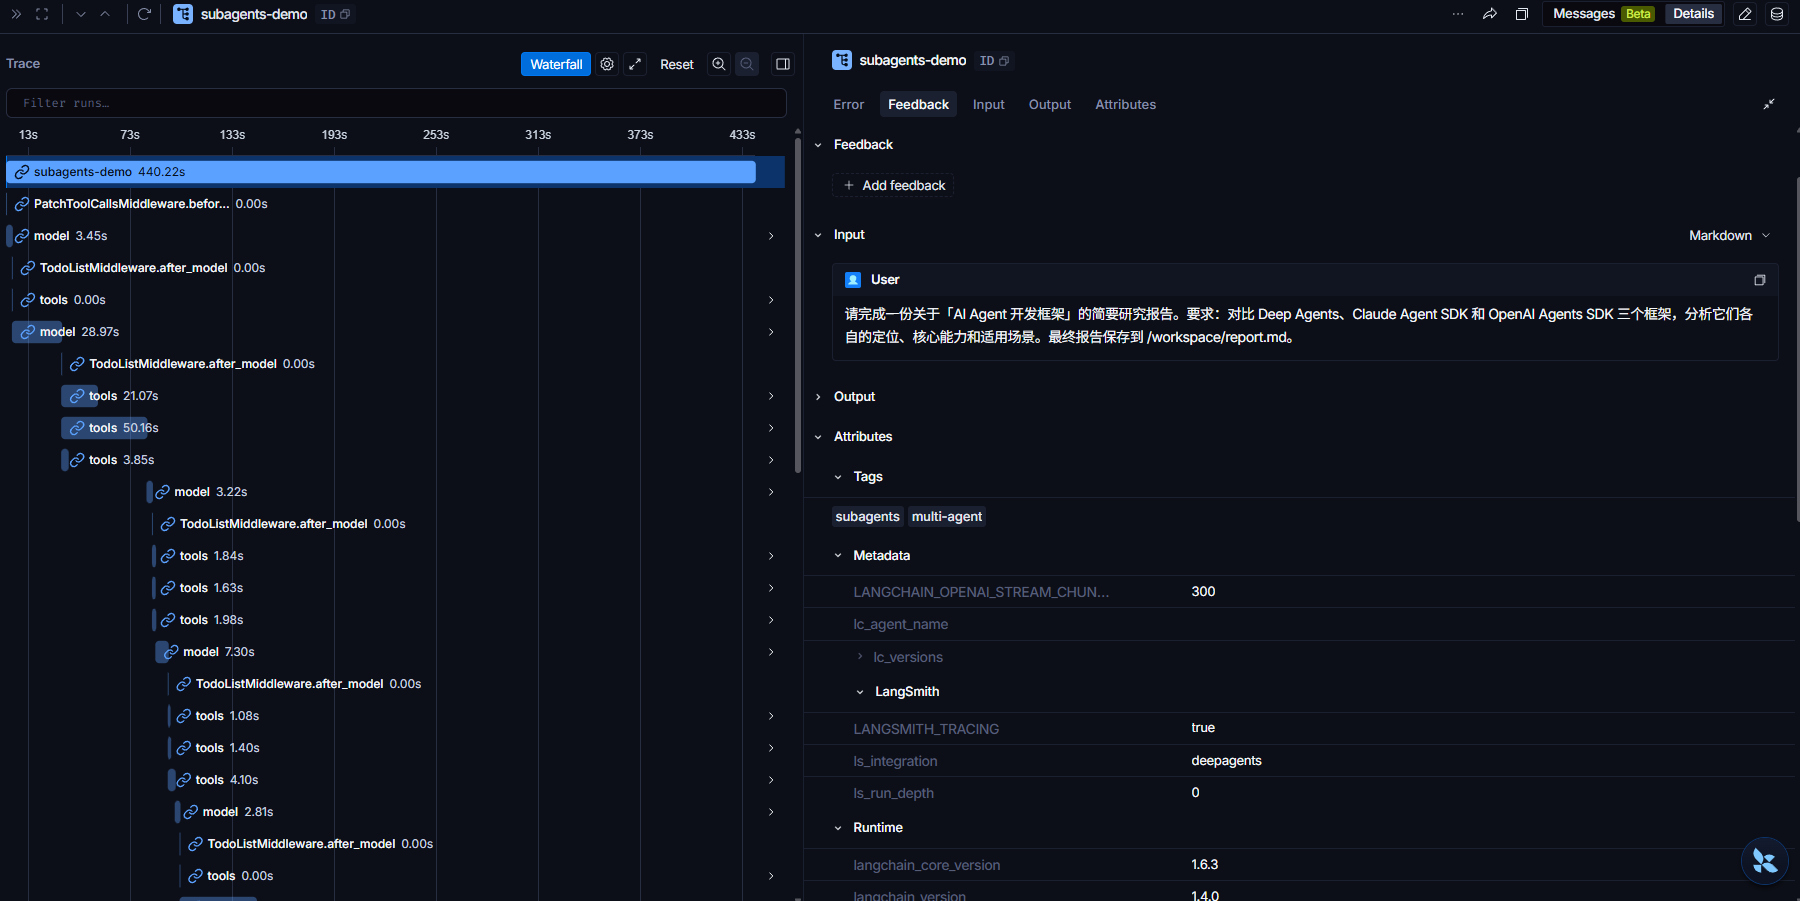
langsmith记录
完整代码
subagents.py
"""
子 Agent 定义模块:三个职责清晰的子 Agent + 主协调 Agent。

设计要点:
- 主 Agent 是"项目经理",负责拆解任务和委派
- 子 Agent 在独立上下文中执行,只返回精炼摘要
- writer 拥有专属工具 finalize_report(主 Agent 无此工具),保证其被调用
"""
import os
from datetime import datetime

from dotenv import load_dotenv
from tavily import TavilyClient
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI
from langchain.agents.middleware import TodoListMiddleware
from deepagents import (
    create_deep_agent,
    GeneralPurposeSubagentProfile,
    HarnessProfile,
    register_harness_profile,
)
from deepagents.backends import StateBackend

load_dotenv()

# ===== 0. 报告输出目录(writer 专属) =====
BASE_DIR = os.path.dirname(os.path.abspath(__file__))
REPORTS_DIR = os.path.join(BASE_DIR, "reports")
os.makedirs(REPORTS_DIR, exist_ok=True)

# ===== 1. 模型 =====
# max_retries=6:遇到 429 TPM 限流时自动指数退避重试
main_model = ChatOpenAI(
    model=os.environ.get("LLM_MODEL_NAME"),
    api_key=os.environ.get("LLM_API_KEY"),
    base_url=os.environ.get("LLM_BASE_URL"),
    max_retries=6,
    request_timeout=120,
)

# 轻量模型(给信息检索员用),换成 TPM 配额更高的模型
fast_model = ChatOpenAI(
    model="XingChenAGI/Xing4.0-29B",
    api_key=os.environ.get("SILICONFLOW_API_KEY"),
    base_url="https://api.siliconflow.cn/v1",
    max_retries=6,
    request_timeout=120,
)

# ===== 2. 注册 Harness Profile,禁用默认 general-purpose =====
register_harness_profile(
    "openai",
    HarnessProfile(
        general_purpose_subagent=GeneralPurposeSubagentProfile(enabled=False),
    ),
)

# ===== 3. 搜索工具 =====
tavily_client = TavilyClient(api_key=os.environ.get("TAVILY_API_KEY"))


def internet_search(query: str, max_results: int = 5) -> dict:
    """Search the web for the given query."""
    return tavily_client.search(query, max_results=max_results)


# ===== 4. writer 专属工具:结构化报告渲染 =====
@tool
def finalize_report(
    title: str,
    summary: str,
    sections: list,
    references: list,
    filename: str = "report.md",
) -> str:
    """将结构化内容渲染为 Markdown 报告并保存到磁盘。

    这是产出最终报告的唯一合规方式。主 Agent 不具备此工具,
    因此最终报告的产出必须委派给 writer 子 Agent。

    Args:
        title: 报告标题
        summary: 摘要段落(1 段话)
        sections: 章节列表,每项形如 {"heading": "小节标题", "content": "正文"}
        references: 来源 URL 或引用列表
        filename: 输出文件名(只使用文件名部分,路径会被忽略),默认 report.md
    """
    # 渲染 Markdown
    lines = [f"# {title}", "", "## 摘要", "", summary, ""]

    if not isinstance(sections, list):
        sections = []

    for i, sec in enumerate(sections, 1):
        if isinstance(sec, dict):
            heading = sec.get("heading", f"第 {i} 节")
            content = sec.get("content", "")
        else:
            heading = f"第 {i} 节"
            content = str(sec)
        lines += [f"## {heading}", "", content, ""]

    if references:
        lines += ["## 参考来源", ""]
        for i, ref in enumerate(references, 1):
            lines.append(f"{i}. {ref}")

    content = "\n".join(lines).strip() + "\n"

    # ===== 关键修复:只取文件名,忽略传入的路径 =====
    safe_filename = os.path.basename(filename) or "report.md"
    if not safe_filename.endswith(".md"):
        safe_filename += ".md"
    path = os.path.join(REPORTS_DIR, safe_filename)

    with open(path, "w", encoding="utf-8") as f:
        f.write(content)

    # 返回元数据(精炼,不回传全文)
    return (
        f"✅ 报告已生成\n"
        f"- 文件路径: {path}\n"
        f"- 字符数: {len(content)}\n"
        f"- 章节数: {len(sections)}\n"
        f"- 生成时间: {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}\n"
        f"- 摘要: {summary[:120]}..."
    )


# ===== 5. 三个子 Agent =====

# ---- 子 Agent 1:信息检索员 ----
researcher_subagent = {
    "name": "researcher",
    "description": (
        "专门用于从互联网搜索和收集事实、数据、最新动态。"
        "任何需要网络搜索的任务都必须委派给此子 Agent。"
        "注意:本子 Agent 只负责搜索和整理原始信息,不做分析和写作。"
    ),
    "system_prompt": """你是一位专业的信息检索员。

执行步骤:
1. 把研究问题拆解为 2-4 个不同的搜索查询
2. 用 internet_search 执行搜索(每次换不同关键词)
3. 提取关键事实、数据和来源 URL
4. 整理成结构化摘要

输出格式:
- 主题概述(2-3 句)
- 关键发现(要点列表,每条附来源)
- 信息缺口(如有)

只返回核心发现,不超过 500 字。不要返回原始搜索结果。""",
    "tools": [internet_search],
    "model": fast_model,
}

# ---- 子 Agent 2:数据分析员 ----
analyst_subagent = {
    "name": "analyst",
    "description": (
        "对已有信息进行深度分析、交叉验证和对比推理。"
        "当你需要对多个信息源进行对比、识别矛盾点、"
        "或提取深层洞察时,委派给此子 Agent。"
        "注意:本子 Agent 不执行网络搜索,也不撰写最终报告。"
    ),
    "system_prompt": """你是一位专业分析师。

执行步骤:
1. 接收主 Agent 提供的研究素材
2. 交叉验证信息,识别一致性和矛盾点
3. 进行对比分析,提取关键洞察
4. 给出明确结论和置信度评估

输出格式:
- 分析结论(3-5 条关键发现)
- 对比表格(如涉及多对象)
- 置信度评估(高/中/低 + 理由)
- 建议下一步

只返回分析结论,不超过 400 字。不要重复原始素材。""",
    "tools": [],
    "model": main_model,
}

# ---- 子 Agent 3:报告撰写员(具备专属工具) ----
writer_subagent = {
    "name": "writer",
    "description": (
        "将分析结论整合为结构清晰、语言专业的最终报告。"
        "【必须委派】任何需要产出最终报告文件的任务,必须委派给此子 Agent。"
        "它使用 finalize_report 工具生成标准化 Markdown 报告并落盘。"
        "注意:主 Agent 不具备 finalize_report 工具,无法自行完成报告产出。"
    ),
    "system_prompt": """你是一位技术写作专家,负责产出最终报告。

你必须使用 finalize_report 工具生成报告,参数要求:
- title: 报告标题(一句话)
- summary: 摘要段落(100-200 字的概述)
- sections: 章节列表,每项是 {"heading": "...", "content": "..."},
  建议 3-5 节,每节正文 150-300 字
- references: 来源 URL 或引用列表
- filename: 只需文件名,如 "report.md"
  (不要传路径,工具会自动处理落盘位置)

【重要约束】
- 不要传 "/workspace/report.md" 之类的绝对路径,只传纯文件名
- 只调用一次 finalize_report,把完整内容一次性传入
- 只返回 finalize_report 的执行结果摘要(约 3-5 行)
- 不要把报告全文回传给主 Agent
- 不要使用 write_file 或其他工具,只使用 finalize_report""",
    "tools": [finalize_report],
    "model": main_model,
}


# ===== 6. 主 Agent 系统提示词 =====
COORDINATOR_PROMPT = """你是一位项目协调者,负责统筹研究报告的完成。

你可用的子 Agent 只有三个:
- researcher:负责所有网络搜索和信息收集
- analyst:负责所有对比分析、深度推理
- writer:负责所有最终报告的撰写和落盘

工作流程:
1. 先用 write_todos 制定研究计划
2. 将信息收集委派给 researcher
3. 将分析工作委派给 analyst(把 researcher 的摘要传给它)
4. 将报告撰写委派给 writer(把 analyst 的结论传给它)
5. 整合输出,形成最终答复

【重要约束】
- 最终报告必须由 writer 使用 finalize_report 工具产出
- 你不具备 finalize_report 工具,无法自行完成报告撰写
- 禁止使用 write_file 写最终报告,那不属于最终报告产出流程
- 委派给 writer 时不要指定具体路径,工具会自动落盘
- 每次委派时把上游结果作为任务描述的一部分传递
- 只接收子 Agent 的精炼返回,保持自己的上下文干净
"""


# ===== 7. 组装主 Agent =====
def create_research_coordinator():
    """创建带三个专业子 Agent 的研究协调 Agent。"""
    return create_deep_agent(
        model=main_model,
        tools=[internet_search],
        system_prompt=COORDINATOR_PROMPT,
        backend=StateBackend(),
        middleware=[TodoListMiddleware()],
        subagents=[
            researcher_subagent,
            analyst_subagent,
            writer_subagent,
        ],
    )
run_subagents.py
"""
运行入口:执行一个需要多子 Agent 协作的复杂研究任务。

展示:
1. 主 Agent 如何用 write_todos 规划任务
2. 主 Agent 如何用 task 工具委派给三个子 Agent
3. 每个子 Agent 在独立上下文中执行,只返回精炼结果
"""
import json
import os

from subagents import create_research_coordinator, REPORTS_DIR


# ===== 1. 创建主 Agent =====
agent = create_research_coordinator()

# ===== 2. 复杂研究任务 =====
query = (
    "请完成一份关于「AI Agent 开发框架」的简要研究报告。"
    "要求:对比 Deep Agents、Claude Agent SDK 和 OpenAI Agents SDK 三个框架,"
    "分析它们各自的定位、核心能力和适用场景。"
    "最终报告由 writer 使用 finalize_report 工具产出。"
)

print("=" * 70)
print("子 Agent 协作测试(已禁用默认 general-purpose)")
print("=" * 70)
print(f"\n任务: {query}\n")

# ===== 3. 执行 =====
result = agent.invoke(
    {"messages": [{"role": "user", "content": query}]},
    config={
        "run_name": "subagents-demo",
        "tags": ["subagents", "multi-agent"],
    },
)

# ===== 4. 最终回答 =====
print("\n" + "=" * 70)
print("最终回答")
print("=" * 70)
print(result["messages"][-1].content)

# ===== 5. 委派过程追踪 =====
print("\n" + "=" * 70)
print("委派过程追踪")
print("=" * 70)

delegations = []
for msg in result["messages"]:
    if hasattr(msg, "tool_calls") and msg.tool_calls:
        for tc in msg.tool_calls:
            if tc.get("name") == "task":
                args = tc.get("args", {}) or {}
                subagent = (
                    args.get("subagent_type")
                    or args.get("agent_name")
                    or args.get("name")
                    or "?"
                )
                task_desc = (
                    args.get("description")
                    or args.get("task")
                    or args.get("prompt")
                    or ""
                )
                delegations.append({
                    "subagent": subagent,
                    "task": task_desc[:150],
                })

if delegations:
    print(f"\n共 {len(delegations)} 次委派:\n")
    for i, d in enumerate(delegations, 1):
        print(f"  {i}. → [{d['subagent']}]")
        print(f"     任务: {d['task']}...")
else:
    print("\n(未检测到 task 工具调用)")

# 如果上面仍显示 ?,打印原始 args 供调试
if delegations and any(d["subagent"] == "?" for d in delegations):
    print("\n--- 调试:原始 task 参数 ---")
    for msg in result["messages"]:
        if hasattr(msg, "tool_calls") and msg.tool_calls:
            for tc in msg.tool_calls:
                if tc.get("name") == "task":
                    print(json.dumps(tc.get("args", {}), ensure_ascii=False, indent=2))

# ===== 6. 任务清单 =====
todos = result.get("todos", [])
print("\n" + "=" * 70)
print("任务清单")
print("=" * 70)
if todos:
    icons = {"pending": "⏳", "in_progress": "🔄", "completed": "✅"}
    for t in todos:
        icon = icons.get(t.get("status", ""), "❓")
        print(f"  {icon} [{t.get('status', '?'):<12}] {t.get('content', '')}")
else:
    print("  (无任务清单)")

# ===== 7. 统计 =====
print("\n" + "=" * 70)
print("统计")
print("=" * 70)
print(f"  消息总数: {len(result['messages'])}")
print(f"  委派次数: {len(delegations)}")
print(f"  任务清单项数: {len(todos)}")

# ===== 8. 检查 writer 产出 =====
print("\n" + "=" * 70)
print("报告产出检查")
print("=" * 70)
print(f"  报告目录: {REPORTS_DIR}")
if os.path.exists(REPORTS_DIR):
    files = [f for f in os.listdir(REPORTS_DIR) if f.endswith(".md")]
    if files:
        for fn in files:
            fp = os.path.join(REPORTS_DIR, fn)
            size = os.path.getsize(fp)
            print(f"  ✅ {fn} ({size} bytes)")
    else:
        print("  ❌ 未找到报告文件")
else:
    print("  ❌ 报告目录不存在")

print(f"\n  子 Agent 详细执行过程不进入主 Agent 上下文(Context Quarantine)。")
踩坑记录
1.在调用子agent 的时候,不知道为啥每次都是调用默认的general_purpose子agent,只能通过禁用默认的agent来避免这个情况

2.刚开始定义的三个子agent中,只有两个子agent被调用到了,因为最后一个writer太简单(角色设计为写入报告,导致agent能力太简单,直接跳过了这个子agent去调用write_file工具了)。
3.用到的子agent太多的话,那么多试几次的话,就可能被限流提示(硅基流动平台的免费模型)
4.主agent使用商汤模型,子agent使用电信模型,完成一次任务在7分钟左右,感觉时间还是有点慢,之后可以换速度快的模型。
5.由于涉及到复杂任务,设计的是搜索agent的话,会调用多次搜索功能,这个时候需要保持网络稳定,不然可能就会报错

关键内容
1.有没有子agent 的区别

2.框架自带的子agent
即使你不定义任何子 Agent,Deep Agents 也自带一个 general-purpose 子 Agent。它是唯一的例外——继承主 Agent 的 system_prompt、tools、model 和 skills;主 Agent 显式启用 Todo 时,它也会继承同一个 Todo Middleware 配置。
3.覆盖默认的子agent
agent = create_deep_agent(
    model=model,  # 主 Agent 复用应用的默认模型
    tools=[internet_search],
    subagents=[
        {
            "name": "general-purpose",  # 覆盖默认
            "description": "通用助手,处理各种委派任务",
            "system_prompt": "你是一个通用助手。",
            "tools": [internet_search],
            "model": ChatOpenAI(  # 子 Agent 用更强的模型
                model="zai-org/GLM-5.2",
                api_key=os.environ["SILICONFLOW_API_KEY"],
                base_url="https://api.siliconflow.cn/v1",
            ),
        },
    ],
)
4.CompiledSubAgent:集成LangGraph工作流
对于更复杂的场景,可以用一个预构建的 LangGraph 图作为子 Agent。这适用于需要多步骤、有分支逻辑的工作流。

参考教程
第5章
https://datawhalechina.github.io/deepagents-in-action/chapters/ch05-subagents/